配置里最安静的那一块:两处从没生效的设置
有人问这个站上跑的代理还能不能更快。我先给了个「大概没多少空间」的判断——链路是跨境直连,带宽也不算小。
但话说出口就该验证,于是去翻了配置和内核计数。结论是:空间很大,但不在我以为的地方。
这篇讲两处「写了但从来没生效」的配置——一个放错了位置的字段,和一个被内核悄悄截断的缓冲区——以及怎么用内核计数而不是感觉来判断这类问题。
先看证据,不看感觉
$ cat /proc/net/snmp | grep Udp
Udp: InDatagrams OutDatagrams …
      1500400     23691503      …
出站是入站的 15.8 倍。一条正常的代理链路不该有这种比例——多出来的部分全是重传。
再看错误计数:
RcvbufErrors: 657
SndbufErrors: 26497
六天里两万六千次「发送缓冲满导致丢包」,平均每小时 184 次。这不是配置问题,是缓冲被写满了。
顺带确认了两个不该动的方向:拥塞控制已经是 BBR,队列是 fq,这两个维度早就是最优解。
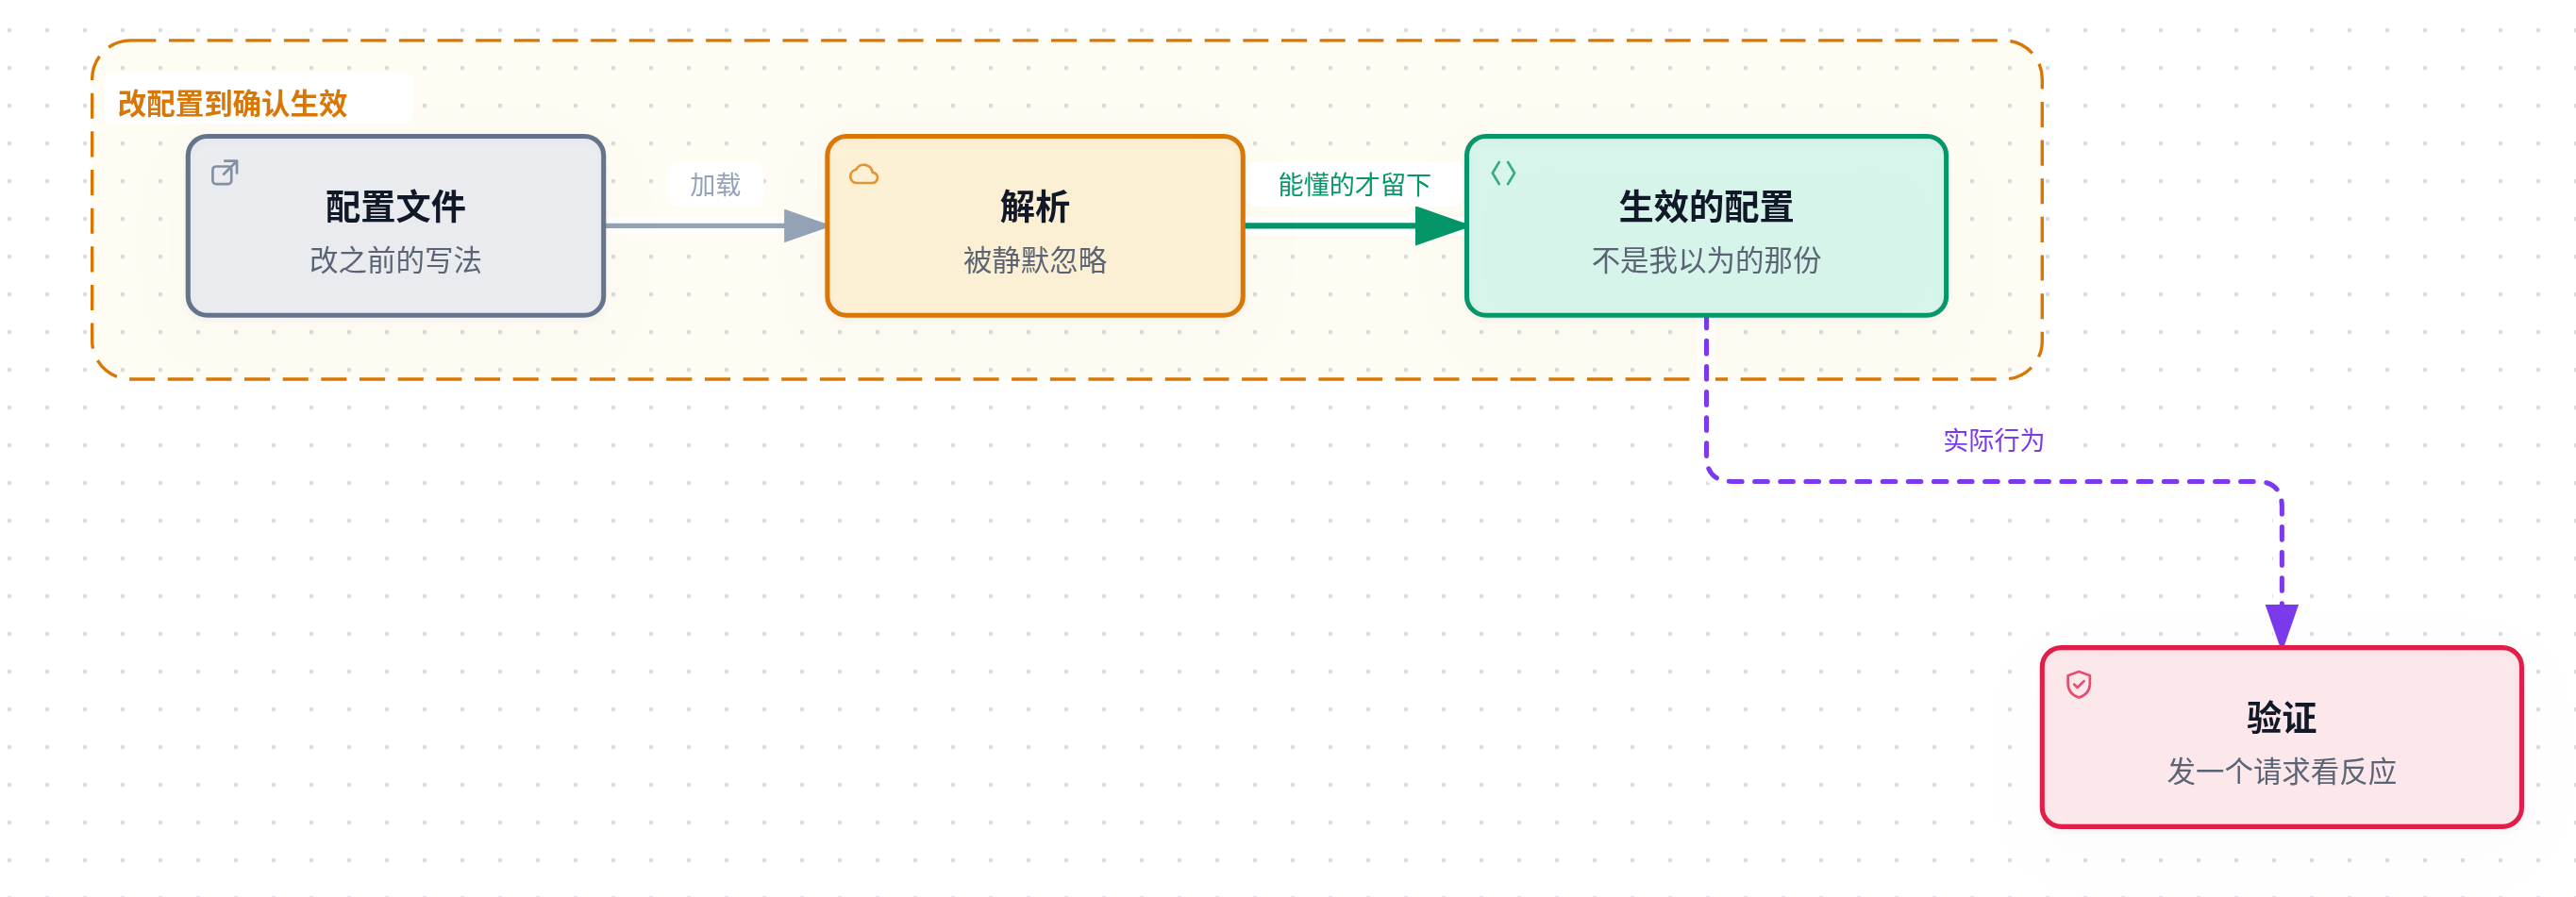
那个从来没生效的字段
配置里有一段看着很专业的东西:
"transport": {
  "kcpSettings": {
    "uplinkCapacity": 100,
    "downlinkCapacity": 100,
    "congestion": true
  }
}
写在一个根本不认识它的位置。这个字段在配置结构里没有定义,整段被静默忽略——服务照常启动、照常工作,日志里一句抱怨都没有。
它真正该待的地方是入站协议的 streamSettings 里。也就是说:过去半年它一直跑的是默认值,而那三行数字给人一种「已经调过」的错觉。
这类错误最难发现,因为它不报错。配置文件的宽容度是双刃剑。
内核把 2 MB 切成 208 KB
默认的内核缓冲区上限是 208 KB:
net.core.rmem_max = 212992
net.core.wmem_max = 212992
而协议层申请的是 2 MB 写缓冲。申请超过上限时,内核不报错,只是给你截断——服务以为自己有 2 MB,实际只有 208 KB。于是高负载时写不进去,包就丢了,前面那个 26497 就是这么来的。
这里有个容易搞错的细节:内核对 SO_SNDBUF 的处理是把请求值翻倍。所以想要 16 MB 有效缓冲,上限得设成 32 MB:
net.core.rmem_max = 33554432
net.core.wmem_max = 33554432
只改 max,不改 default——只有显式申请的地方才需要这个大值,动 default 会让所有 socket 都膨胀。
验证办法很直接:申请 16 MB,看内核实际给多少。
申请 16777216 → 实际 33554432
翻倍,符合预期。
congestion 关掉意味着什么
协议默认 congestion: false,也就是从不退让。
好处是丢包时不会像 TCP 那样立刻降速,坏处是链路真的拥塞时,包会堆在队列里而不是堆在发送方。队列一满,RTT 就从 158 ms 涨到 400~600 ms,然后触发连锁:缓冲写满、内核丢包、协议层重传、队列更满。
所以症状不是「一直慢」,而是时快时慢、视频转圈、首帧要等四五秒。
这个行为在跨境直连上尤其明显,因为链路本身的缓冲区就不大。
另一个安静的坑:DNS 套娃
重启之后翻错误日志,发现一组反复出现的超时:
failed to retrieve response > Post "https://dns.example/dns-query": context canceled
三十三分钟八条,大约每小时十五次。
第一反应是「到那个 DNS 服务商很慢」,实测是 1.4 ms,就近节点,快得离谱。
真正的原因是循环依赖:解析域名用的是 DNS over HTTPS,而 HTTPS 连接的第一步是先解析那个 DNS 服务器自己的域名。于是每次新域名都要等它超时,再回退到明文 DNS。
而路由策略是 UseIP——每个新域名都要先解析。等于每个新连接都先空等一轮。
改成直接用两个 UDP DNS,问题消失:五分钟零条错误。
这个坑的教训不是「DoH 不好」,而是引导问题:任何用来解析域名的东西,自己不能依赖域名解析。
改完的数字
重启后 33 分钟:
| 指标 | 改前 | 改后 |
|---|---|---|
| 发送缓冲丢包 | 184 次/小时 | 30.9 次/小时 |
| 收缓冲丢包 | 有 | 0 |
| 出/入比 | 15.8 | 1.45 |
高负载段(连看三分钟视频):出站 88 KB 包,丢 88 个,丢包率 0.099%;改前累计是 0.112%。
丢包率几乎没变,但吞吐量是之前的几十倍。
这句话值得琢磨:优化掉的不是「丢包」,是「轻载时白白丢掉的包」。载重上来之后,链路就回到它本来的水平。
没做的事
还有几条没动:
- 日志级别降到 error —— 现在每连接一条 warning,一天约 24000 条、2.4 MB
routeOnly—— 能让嗅探只用于路由不改目标- 路由策略从
UseIP改成AsIs—— 少一次解析,但可能走错节点
这些都要再重启一次,收益也远小于前面两项,先记在 monitor 那套告警里观察。
顺手也该盯一下内存:这个进程从 73 MB 涨到 134 MB 用了 22 小时,还没看到拐点。